從量測到點雲地圖
SLAM 設備交出的點雲地圖,是一連串中間資料的最後一步:原始掃描、特徵或降採樣點、對應、位姿更新,最後才放進某種地圖表示。本頁在同一個施工中樓層的模擬上,逐步拆開四類代表性管線(LOAM 類 LiDAR 里程計、直接法 LiDAR 慣性里程計、特徵法視覺 SLAM、RGB-D 稠密融合),看每一步產生什麼資料,並比較它們最後交付的地圖型態。
本頁內容
四條管線的共同骨架
本頁把每條管線拆成相同的三段,這是為了比較而採用的分解方式,不是某篇文獻的定義:
- 前端:把感測資料整理成可比對的形式(特徵點、降採樣點、影像特徵或深度點),並在地圖或前一幀中找出對應。
- 估計:以對應的殘差求位姿,可能是最佳化,也可能是濾波;位姿誤差會直接寫進之後放上地圖的每個點(F-01)。
- 建圖:依估計的位姿把量測放進某種地圖表示;表示方式決定最後交付的是原始點、降採樣點、稀疏地標還是表面。
四個模擬共用同一個場景:一層施工中的鋼筋混凝土樓板,有方柱與圓柱、澆置完成的牆、仍在模板中的牆與斜撐、階梯狀空心磚牆、鋼筋網、材料棧板、樓梯與電梯核、鷹架、試裝玻璃、一團切磚粉塵與一位走動的工人。每張圖都可以逐步切換,也可以開啟「自動換步」依序播放。
LiDAR 里程計(LOAM 類):特徵、對應、位姿、地圖
LOAM(Lidar Odometry and Mapping) 把 LiDAR 的同時定位與建圖拆成兩個並行、頻率不同的演算法:高頻的里程計以掃描對掃描配準估計運動並校正畸變,低頻的建圖再把去畸變後的點雲精細配準到地圖;作者的系統兩者分別約為每秒 10 次與 1 次,並以 Levenberg-Marquardt 搭配 bisquare 權重求解(Zhang & Singh, 2014, Sec. IV-B, V-C, VI)。兩個演算法都只使用依局部平滑度(local smoothness)從每條掃描線挑出的邊緣點與平面點,分別以點到線、點到面的距離作為殘差;建圖階段以地圖中局部點群的特徵值分析判斷對應的是直線或平面(Zhang & Singh, 2014, Sec. V-A, V-B, VI)。地圖由去畸變的掃描配準而成,以 5 cm 體素格網降採樣,分存在 10 m 立方塊中,與新掃描相交的立方塊載入 KD 樹搜尋(Zhang & Singh, 2014, Sec. VI; Fig. 8)。系統沒有迴圈閉合(Zhang & Singh, 2014, Sec. I, VIII)。
本站的證據紀錄記下 LOAM 依同一掃描線的局部平滑度挑點,但沒有逐式摘錄公式與門檻。下方模擬採用以下定義:對掃描線上的點 (感測器座標),取前後各 5 個相鄰點為 ,
平面上的點與鄰點近似對稱,差向量互相抵消, 趨近 0;柱角、牆端與深度跳變處不對稱, 變大。除以 使遠近的點能用同一門檻。這是本模擬的實作選擇(前後點數、正規化方式、每條掃描線分 6 區、每區至多 3 個邊緣點與 5 個平面點、門檻 0.02 與 0.004 都是示意參數),不是從原文逐式轉錄的結果。對應的殘差是(幾何定義,不是特定文獻的結果):
是點到擬合直線的距離, 是點到擬合平面的有號距離; 是待估位姿, 是地圖點群的中心, 是擬合直線的方向, 是擬合平面的法向量。各項殘差如何組成最小平方問題、穩健權重如何壓低錯誤對應,見 F-02。
原始掃描:推車上的 LiDAR 轉一圈,點依預測位姿放上地圖;預測有誤差,所以牆與柱出現雙層。光束打在真實表面上,但記錄下來的點跟著錯誤的位姿偏移。
三維教學模擬:操作者推著裝有旋轉式 LiDAR 的推車行經施工中樓板,周圍有柱、牆、模板、棧板與鋼筋網。依步驟顯示一圈掃描依預測位姿擺放的原始點、以顏色與大小表示的局部平滑度、邊緣點與平面點、到地圖直線與平面的殘差連線、位姿迭代更新,以及插入 5 cm 體素地圖的新點。
三維場景載入中…
操作方式:拖曳旋轉視角,右鍵或 Shift 加拖曳平移;點選畫面後可用滾輪縮放;觸控時水平拖曳旋轉、雙指縮放,垂直滑動捲動頁面。聚焦畫面後,方向鍵平移,Shift 加方向鍵旋轉,加號與減號縮放,數字 0 重設視角。所有動作也可用下方工具列完成。
看什麼:(1)第 1 步的預測位姿與真值差約 34 cm 與 3.5°(刻意設定),所以點在牆邊形成第二層;光束仍打在真實表面上,錯的是記錄時用的位姿。(2)第 2 至 3 步:平滑度在柱角、牆端、斜撐與鋼筋等不連續處較大,在平面上較小。第 3 步的讀數列依模擬中每個點實際打到的構件,列出兩類特徵點的分布:平面點多半落在樓板與牆面(比例見讀數列),邊緣點以落在柱上的最多,斜撐、牆端與鋼筋也有;粉塵與走動的工人同樣會被挑為特徵。這個分類只有模擬知道,演算法無法事先分辨。(3)第 4 至 5 步:每次迭代都重新找對應;模擬以 bisquare 權重(尺度逐次縮小)壓低殘差大的對應,殘差連線縮短,位姿誤差降到約 1 公分以內(讀數列)。(4)第 6 步:新點只補在地圖原本沒有的體素,已有的體素保留較接近中心的點。
簡化條件:16 線、每圈 900 行、每秒 10 圈、測距雜訊 6 mm,均為示意參數;本圖假設掃描已依真實運動去畸變(去畸變見 D-07b 與 F-01),地圖由前 10 圈以真實位姿建成,因此只呈現一次掃描對地圖的配準,不含里程計與建圖兩個執行緒的分工。推車的操作者只是外觀示意:模擬的掃描不含其身體的遮擋,圖中也不畫穿過身體的光束。
教學視覺化:圖中可見的雷射光束、相機射線,以及點與體素的顏色都是教學視覺化:近紅外雷射與主動式深度相機投射的紅外光在真實環境中人眼看不見。場景是模擬,不是實測資料;設備是通用外型,不對應任何產品。
LeGO-LOAM 與 LIO-SAM 等後續系統保留這套特徵與殘差設計,改的是前處理與地圖。LeGO-LOAM 先把點雲投影成距離影像,分離地面點,以影像分割剔除少於 30 點的小群集,邊緣特徵只取自非地面點;位姿以兩步驟 Levenberg-Marquardt 求解,先以地面平面特徵求 z、橫滾與俯仰,再以邊緣特徵求 x、y 與偏航(Shan & Englot, 2018, Sec. III-B to III-D)。LIO-SAM 同樣使用 LOAM 式邊緣與平面特徵,但新關鍵影格只與 25 個近期子關鍵影格組成的局部體素地圖配準,地圖只保留位姿改變 1 m 或 10° 的關鍵影格特徵點雲,其間的 LiDAR 影格被捨棄(Shan et al., 2020, Sec. III-C)。
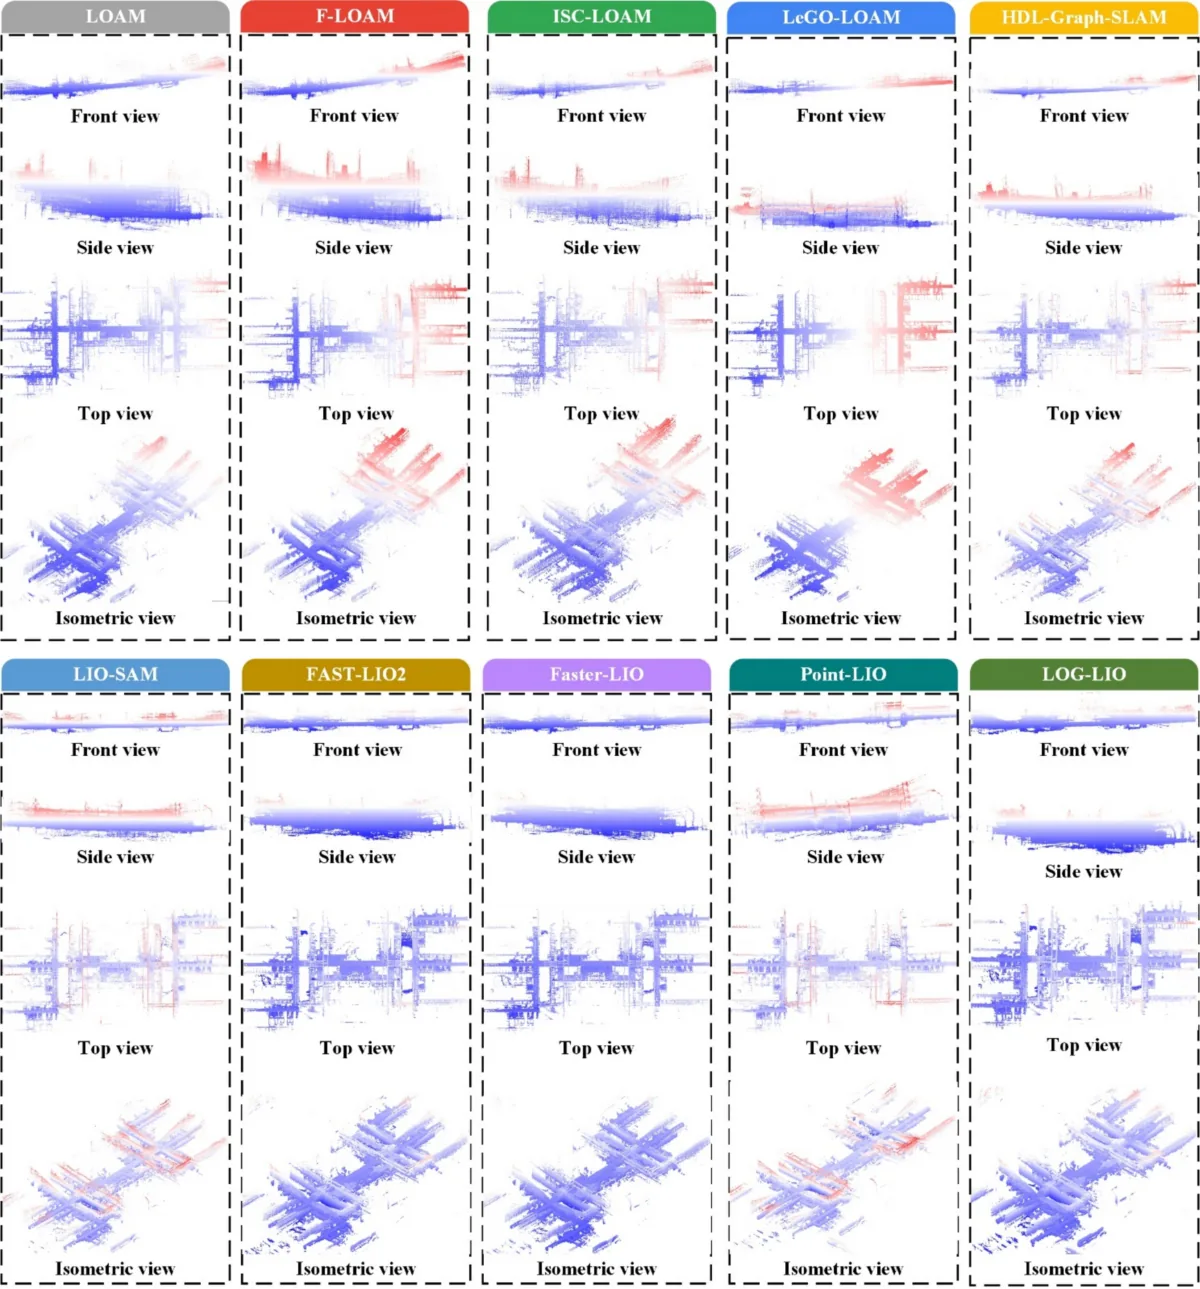
Feng 等在一棟主體封頂、進入機電與裝修階段的醫院門診大樓,以及依施工圖建立的模擬工地,比較十種開源 3D LiDAR SLAM;作者報告只用 LiDAR 的方法普遍在垂直方向累積漂移並造成地圖翹曲,緊耦合 LiDAR 與 IMU 的方法可減輕這個現象(Feng et al., 2025, Sec. 5.2-5.3)。
LiDAR 慣性里程計(直接法迭代卡爾曼濾波類)
FAST-LIO 以迭代擴展卡爾曼濾波(iterated extended Kalman filter, iEKF)緊耦合融合 LiDAR 特徵點與 IMU:IMU 前向傳播進行預測,再以反向傳播把掃描內每個特徵點補償到掃描結束時刻(Xu & Zhang, 2021);作者提出與傳統式等價、但計算量取決於狀態維度而非量測維度的卡爾曼增益,使大量點能在機載電腦上即時融合(Xu & Zhang, 2021, abstract; Sec. III-C)。FAST-LIO2 取消手工特徵擷取,直接把降採樣後的原始點與地圖中 5 個最近點擬合的局部平面做點到面配準;狀態共 24 維,含 LiDAR 與 IMU 之間的外參;地圖以增量式 k-d 樹(ikd-Tree)維護,支援逐點插入、刪除與樹上降採樣(Xu et al., 2022)。作者指出取消特徵擷取使系統能用於掃描樣式不同的 LiDAR(Xu et al., 2022, abstract; Sec. VIII),並說明它是沒有迴圈偵測與修正的里程計(Xu et al., 2022, Sec. VI-C)。
逐點補償只是把每個點用它自己時刻的位姿轉到掃描結束時刻(剛體轉換的一般推導,不是特定文獻的結果;去畸變的各種作法見 F-01):
在這裡來自 IMU 的積分,而不是等速假設。迭代更新則可以寫成對下式做高斯牛頓迭代:以 IMU 傳播的狀態 與共變異 為先驗,點到面殘差 為量測,每次迭代在新的估計處重新線性化並重新找平面(估計理論的一般推導,不是特定文獻的結果;濾波與平滑的比較見 F-03):
IMU 傳播:掃描器快速轉身,這一圈 0.1 s 內 IMU 取樣 21 次(含頭尾)。以慢動作重播:每次取樣都積分出新的機體位姿,圖中每 10 ms 畫一組彩色座標軸;位置不確定度(橙色 3σ 橢球)隨時間變大。圖下方的小圖是 IMU 量到的偏航角速度。
三維教學模擬:操作者手持 SLAM 掃描器,在施工樓板上邊走邊快速轉身。依步驟顯示一圈掃描期間 IMU 傳播出的機體座標軸與逐漸變大的位置不確定度橢球、未補償與以 IMU 補償後的點雲比較、降採樣原始點到地圖平面的殘差、迭代更新時位姿與橢球的收斂,以及逐點插入地圖的新點。
三維場景載入中…
操作方式:拖曳旋轉視角,右鍵或 Shift 加拖曳平移;點選畫面後可用滾輪縮放;觸控時水平拖曳旋轉、雙指縮放,垂直滑動捲動頁面。聚焦畫面後,方向鍵平移,Shift 加方向鍵旋轉,加號與減號縮放,數字 0 重設視角。所有動作也可用下方工具列完成。
看什麼:(1)第 1 步以慢動作重播 0.1 s 的一圈:每次 IMU 取樣都積分出新的位姿(圖中每 10 ms 畫一組座標軸),3σ 橢球變大,因為陀螺儀與加速度計的雜訊,以及偏差估計的不確定度,都隨積分累積。(2)第 2 步比較兩團點:橙色圓環是直接疊合的結果,在 150°/s 時一圈內轉了約 15°,點位平均偏離數十公分,遠處的牆被拉開,起訖接縫錯開;青色是逐點補償後的結果(讀數列列出兩者每個點與其真實回波位置的平均距離)。把轉身角速度調到 30°/s,一圈內只轉約 3°,未補償的誤差也跟著變小。(3)第 3 至 4 步:先驗位姿與真值差數公分;迭代數次後殘差縮短、橢球收縮,讀數列顯示位置不確定度(三軸合成 1σ)由公寸級降到約 1 公分。(4)第 5 步:新點補在地圖沒有的體素;已有點的體素只在新點更接近體素中心時才取代舊點。
簡化條件:IMU 與 LiDAR 共用機體座標且時間同步;IMU 每秒 200 次,雜訊與偏差為示意參數,濾波器同時估計兩種偏差;起始狀態與真值有數公分與約 1° 的差距(刻意設定);地圖由前 10 圈以真實位姿建成,體素 10 cm。濾波器的狀態只含姿態、速度、位置與兩種偏差,不含外參,重力視為已知常數。持掃描器的操作者只是外觀示意:模擬的掃描不含其身體的遮擋,圖中也不畫穿過身體的光束。
教學視覺化:圖中可見的雷射光束、相機射線,以及點與體素的顏色都是教學視覺化:近紅外雷射與主動式深度相機投射的紅外光在真實環境中人眼看不見。場景是模擬,不是實測資料;設備是通用外型,不對應任何產品。
視覺 SLAM(特徵法):從影像特徵到稀疏地圖
ORB-SLAM 以同一組 ORB 特徵同時支援追蹤、局部建圖、重定位與迴圈閉合,分成三個平行執行緒(Mur-Artal et al., 2015);特徵是在 8 個尺度層偵測的 FAST 角點,512×384 至 752×480 的影像約取 1000 個,並以網格分散(Mur-Artal et al., 2015, Sec. III-A, III-E, V-A to V-D)。ORB-SLAM3 的局部建圖最佳化一個滑動視窗內的關鍵影格與其地圖點,共視的關鍵影格保持固定(Campos et al., 2021, Sec. II-B, V-A to V-C);每張新關鍵影格以 DBoW2 找出三張最相似且不共視的候選,對候選的局部視窗以 RANSAC 與 Horn 方法對齊 3D 對 3D 匹配,並在三張已在地圖中的共視關鍵影格驗證(Campos et al., 2021, Sec. VI-A);確認迴圈後先在迴圈兩端的焊接視窗融合重複的地圖點,再在 Essential Graph 上做位姿圖最佳化,最後於獨立執行緒做全域光束法平差;視覺慣性模式下,全域光束法平差只在關鍵影格數低於門檻時執行(Campos et al., 2021, Sec. V-B, VI-B to VI-D)。
兩張影像的匹配本身不含深度,要靠射線交會;單眼系統的尺度也不是公制,ORB-SLAM 的精度是在與真值對齊尺度後報告的(Mur-Artal et al., 2015, Sec. IX-A),視差不足的點不用於追蹤(Mur-Artal et al., 2015, Sec. IX-C)。本模擬的相機位姿與地標都以公制表示,並以兩個固定的共視影格固定尺度與座標。
特徵與匹配:兩張關鍵影格的影像貼在各自視錐的像平面上。影像分成 16×9 格,空格中角點出現的機率依材質紋理而定(示意參數);黃色線連接兩張影像中同一個地標的觀測,本模擬假設這些匹配全部正確。
三維教學模擬:搭載前視相機的無人機在施工樓層上方繞行一圈。依步驟顯示兩張關鍵影格的影像、特徵與匹配線,射線交會三角化出的地標,沿路線加入的關鍵影格與共視邊,局部光束法平差中調整與固定的影格,回到起點時的迴圈邊與漂移修正,以及最後的稀疏地標地圖。
三維場景載入中…
操作方式:拖曳旋轉視角,右鍵或 Shift 加拖曳平移;點選畫面後可用滾輪縮放;觸控時水平拖曳旋轉、雙指縮放,垂直滑動捲動頁面。聚焦畫面後,方向鍵平移,Shift 加方向鍵旋轉,加號與減號縮放,數字 0 重設視角。所有動作也可用下方工具列完成。
看什麼:(1)第 1 步的像平面是從關鍵影格位置實際算繪的畫面;影像每格至多新增一個角點,出現的機率依材質而定:空心磚、鋼筋、水泥袋與木料最高,帶模板紋的清水混凝土與模板居中,樓板較低,玻璃為零(示意參數)。(2)第 2 步:三角化的三角形與真實位置的圓環不重合,讀數列的中位數差距達公寸級;兩張影格的基線約 1.8 m,而且大致沿視線方向前進,遠處地標的交會角很小,差得更多。(3)第 3 步:軌跡只由相鄰影格的相對運動累積,每公尺約 0.35° 的航向漂移、1% 的距離比例誤差與少量高度漂移(示意)使回到起點時差了數十公分與數度。(4)第 4 步:固定影格不動,其餘影格與地標一起調整,讀數列的重投影誤差降到約 1 像素,地標位置誤差的中位數也跟著下降。(5)第 5 步:迴圈邊讓軌跡與地標移回原處。(6)第 6 步:輸出只有約一千個地標。
簡化條件:影像 640×360 像素、水平視角 78°、像素雜訊 1 px;角點出現的機率依材質紋理設定(示意參數);資料關聯假設完全正確,沒有錯誤匹配;迴圈修正以位置加航向的四自由度位姿圖簡化,ORB-SLAM3 的 Essential Graph 與全域光束法平差未完整實作。
教學視覺化:圖中可見的雷射光束、相機射線,以及點與體素的顏色都是教學視覺化:近紅外雷射與主動式深度相機投射的紅外光在真實環境中人眼看不見。場景是模擬,不是實測資料;設備是通用外型,不對應任何產品。
ORB-SLAM3 的輸出是關鍵影格軌跡與稀疏地圖點;在 EuRoC V202 序列上,四種設定保留 9,686 至 14,245 個地圖點(Campos et al., 2021, Table VI),論文沒有產生或評估稠密重建(Campos et al., 2021)。ORB-SLAM2 論文中的稠密點雲,是以估計的關鍵影格位姿反投影感測器深度圖所得,不是融合或最佳化後的表面(Mur-Artal & Tardos, 2017, Sec. IV-C; Fig. 7)。
ORB-SLAM3 的作者指出低紋理環境是主要失效情境(Campos et al., 2021, Sec. VIII)。在室內施工現場錄製的一個視覺 SLAM 資料集中,作者報告 ORB-SLAM 在貼近灰色低紋理牆面時無法完成軌跡(Li et al., 2025, Sec. 3, Fig. 2, Fig. 8b);這是會議論文集中的定性觀察,該文的同儕審查狀態本站尚未確認。
RGB-D 稠密融合:深度影像、TSDF 與表面
KinectFusion 把深度相機的影格即時融合到單一全域的截斷有號距離函數(truncated signed distance function, TSDF)體素模型,並以光線投射產生的模型表面預測做影格對模型的追蹤(Newcombe et al., 2011b):追蹤使用雙邊濾波後的深度做投影式資料關聯,融合進 TSDF 的則是原始深度(Newcombe et al., 2011b, Sec. 3.2; Sec. 3.3 last paragraph; Sec. 3.5 Eq. 17);ICP 以點到面距離在最底 3 層金字塔上由粗到細進行,最粗到最細的三層分別最多迭代 4、5 與 10 次(Newcombe et al., 2011b, Sec. 3.5, Eq. 16 to 26);TSDF 以投影方式、最近像素查表,並以加權的累計平均更新,可設權重上限讓動態場景以移動平均重建(Newcombe et al., 2011b, Sec. 3.3; Sec. 4.1; Fig. 13)。體積融合的原型來自 Curless 與 Levoy:每張已對齊的距離影像沿視線轉成有號距離與權重,逐張加權累加到體素格網,最後擷取零等值面成為三角網格(Curless & Levoy, 1996)。
下方模擬的反投影與融合依以下關係(相機幾何與加權平均的一般推導,不是特定文獻的結果)。相機座標取 x 沿光軸向前、y 向左、z 向上,像素座標 u 向右、v 向下; 是像素 (u, v) 量到的深度, 是以像素計的焦距, 是主點。融合式中 為截斷距離, 為第 k 張深度在該體素投影像素的量測, 為體素沿光軸的深度,每次觀測的權重為 1:
RGB-D Mapping 的作者描述這類相機的深度量程通常小於 5 m、3 m 處雜訊約 3 cm、視野約 60°(Henry et al., 2012, Sec. 1);模擬的深度雜訊依這個量級設定(在 3 m 處約 3 cm),其餘為示意參數。
深度影格:手持深度相機拍下一張深度影像,貼在視錐的像平面上:每個像素是沿光軸的距離,藍色近、紅色遠,近黑色是沒有回傳的空洞。
三維教學模擬:操作者手持深度相機,沿施工樓板西南角的材料棧板與階梯狀空心磚牆移動。依步驟顯示貼在視錐上的深度影像、反投影的三維點與法向量、新影格對模型預測的投影式點到面對齊、逐影格融合的 TSDF 水平切片與表面附近的體素磚,以及在零交越處擷取、依與真實表面距離著色的表面點。
三維場景載入中…
操作方式:拖曳旋轉視角,右鍵或 Shift 加拖曳平移;點選畫面後可用滾輪縮放;觸控時水平拖曳旋轉、雙指縮放,垂直滑動捲動頁面。聚焦畫面後,方向鍵平移,Shift 加方向鍵旋轉,加號與減號縮放,數字 0 重設視角。所有動作也可用下方工具列完成。
看什麼:(1)第 1 步的深度影像有空洞:超出量程的遠處與掠射角過大的面(模擬中細鋼筋也有一半像素沒有深度,但不在這個視野內)。(2)第 2 步:每條射線停在量測深度上,點的密度隨距離變稀。(3)第 3 步是為了看清收斂,在追蹤結果上再刻意偏移的起點;讀數列的兩個位姿差都相對於真實位姿,收斂後仍差數公分,因為 ICP 對齊的是由帶追蹤誤差的位姿融合出的模型,而不是真實表面。實際追蹤時以等速模型外推初始位姿。(4)第 4 步:表面兩側各有一層由藍轉白、再由白轉橙的體素;融合的影格越多,方塊越高,也就是權重越大。圖下方的小圖是最後一張影格中央光線上的有號距離,過了表面後迅速降到負值,再往後因為超過截斷距離而沒有觀測。把體素改成 12 cm,截斷距離(體素的 2.5 倍)隨之加大,表面點變少,讀數列中與真實表面的距離也跟著改變。(5)第 5 步:預設 6 cm 體素時,約一半的表面點離真實表面 3 cm 以內(讀數列的中位數);誤差來自逐影格的追蹤誤差(讀數列)、深度雜訊與體素化,三者在這個模擬中混在一起。
簡化條件:深度影像 96×72 像素、水平視角 70°、量程 0.4 至 4.5 m、40 張影格;深度雜訊 σ = 0.0033 z²(z 為沿光軸的深度,m);追蹤只用單一解析度的投影式 ICP,逐影格追蹤仍有數公分的誤差(讀數列);本模擬的深度相機不受粉塵、日照與反光影響,也不處理顏色。持相機的操作者只是外觀示意,站在相機後方,不在模擬的深度影像中。
教學視覺化:圖中可見的雷射光束、相機射線,以及點與體素的顏色都是教學視覺化:近紅外雷射與主動式深度相機投射的紅外光在真實環境中人眼看不見。場景是模擬,不是實測資料;設備是通用外型,不對應任何產品。
KinectFusion 的作者指出,大面積平面占滿視野時 ICP 有三個自由度不受約束,追蹤會漂移或失敗(Newcombe et al., 2011b, Sec. 4.3);系統適合中等大小的房間;若要重建整棟建築內部,會遇到記憶體問題,漂移也會在迴圈閉合處表現為錯位(Newcombe et al., 2011b, Sec. 6 Conclusions);深度在不反射紅外光的材料、細長結構與掠射角的表面會有空洞,快速移動時也有動態模糊(Newcombe et al., 2011b, Sec. 2.1)。Curless 與 Levoy 指出,有號距離的斜坡延伸到表面背後,會與另一側表面的觀測互相干擾,使薄面增厚、尖角變圓(Curless & Levoy, 1996, Sec. 7);他們以空間雕刻補洞產生的面,並不是觀測到的幾何(Curless & Levoy, 1996, Sec. 4, Fig. 11)。
在營建現場以 RGB-D 相機即時重建的研究中,Shang 與 Shen 的工作屬先導研究:他們在無人機底部裝設 RGB-D 相機,以 RTAB-Map 即時重建碎石基礎溝槽,並指出紅外線量程有限造成模型中央的空洞;他們以攝影測量模型為參考、只比較 8 個角點間的距離,且未考慮量測誤差(Shang & Shen, 2018, Field applications: Accuracy Evaluation)。
最後交付的是什麼
四條管線交付的地圖型態不同,本站的紀錄也據此記下各自的輸出:LOAM 是由去畸變掃描配準、以 5 cm 體素降採樣的點雲地圖與約每秒 10 次的位姿(Zhang & Singh, 2014, Sec. VI);LIO-SAM 是由關鍵影格的邊緣與平面特徵組成的全域特徵地圖,論文沒有描述稠密地圖的輸出(Shan et al., 2020, Sec. III-C; Figs. 4 to 7);FAST-LIO2 是以里程計頻率插入的稠密點雲地圖,論文沒有報告輸出格式(Xu et al., 2022);ORB-SLAM3 是稀疏地圖點與關鍵影格軌跡(Campos et al., 2021, Table VI);KinectFusion 的 TSDF 表面以光線投射呈現,本站讀過的章節沒有報告網格輸出(Newcombe et al., 2011b);Curless 與 Levoy 則擷取零等值面成為三角網格(Curless & Levoy, 1996)。若要讓 LiDAR 點帶有相機拍到的實際顏色,還要把點投影到同步的影像上取色,見 D-08 彩色點雲:LiDAR 加相機。
下圖把四種模擬輸出放在同一個樓層上,並以模擬中已知的真實表面計算每一點的距離。
原始點:LiDAR 慣性管線逐圈補償、更新後,每一個回波都保留下來,粉塵與走動的工人也在其中(圓環)。
三維教學模擬:同一施工樓層上四種模擬管線的輸出可逐一切換,依序為 LiDAR 慣性管線配準後的全部原始點、LOAM 類管線的 5 cm 體素地圖、特徵法視覺 SLAM 的稀疏地標,以及 RGB-D 融合的 TSDF 表面點;點依與模擬真實表面的距離或高度著色,粉塵與移動工人造成的點以圓環表示;各路線的終點放著產生該輸出的設備。
三維場景載入中…
操作方式:拖曳旋轉視角,右鍵或 Shift 加拖曳平移;點選畫面後可用滾輪縮放;觸控時水平拖曳旋轉、雙指縮放,垂直滑動捲動頁面。聚焦畫面後,方向鍵平移,Shift 加方向鍵旋轉,加號與減號縮放,數字 0 重設視角。所有動作也可用下方工具列完成。
看什麼:(1)原始點最密,也把粉塵團(樓板西南角)與走動的工人一起留下;這些點以圓環表示,離靜態表面多在數十公分以上,距離著色為紅色。(2)體素地圖每 5 cm 只留一點,牆面上的密度變均勻;但空中零散的粉塵點各佔一個體素,所以它們在點數中的比例反而上升(表格最後一欄)。(3)稀疏地標只有約一千點,只標出角點所在的位置,描不出連續的牆面與樓板。(4)TSDF 表面只涵蓋深度相機看過的西南角,表面連續。Curless 與 Levoy 指出,在逐體素加權平均有號距離的體積融合中,表面背後延伸的距離斜坡會與另一側表面的觀測互相干擾,使薄面增厚、尖角變圓(Curless & Levoy, 1996, Sec. 3, Sec. 7)。切到這一步時,讀數列另列出兩個受控小實驗:以同一套融合程式、真實位姿與無雜訊深度,分別融合兩面都被看到的 3 cm 薄板,以及從外側環繞觀測的直角凸稜。薄板重建後的厚度隨截斷距離改變,呈現的正是上述斜坡干擾(本模擬每次觀測的權重都是 1,表面背後的觀測不遞減,所以干擾特別明顯);直角凸稜的表面內縮則幾乎不隨截斷距離改變,而與體素大小成比例(單元測試中 12 cm 體素的內縮約為 6 cm 體素的兩倍),主要來自體素取樣與內插,不是斜坡干擾。距離的中位數與 95 百分位只描述這個模擬:它們混合了雜訊、漂移、體素化與表示方式的影響,不能用來排列方法優劣。
簡化條件:兩條 LiDAR 管線使用同一部推車、同一條路線與相同時刻的 14 圈掃描(每 0.4 s 處理一圈,測距雜訊各自抽樣),視覺 SLAM 與 RGB-D 分別沿 D-07c 與 D-07d 的路線;距離以每種輸出至多 4,000 個抽樣點、對模擬中的靜態表面計算,粉塵與工人造成的點不列入距離統計而另外計算比例。受控小實驗的場景只有薄板或方塊與地面,深度相機與體素大小同 D-07d,截斷距離取體素的 2.5 倍及其一半。圖中的推車、無人機與手持深度相機只標出各條路線結束時的位置。
教學視覺化:圖中可見的雷射光束、相機射線,以及點與體素的顏色都是教學視覺化:近紅外雷射與主動式深度相機投射的紅外光在真實環境中人眼看不見。場景是模擬,不是實測資料;設備是通用外型,不對應任何產品。
近年的神經隱式與三維高斯地圖又是另一種輸出。NICE-SLAM 以多層級特徵網格搭配預先訓練的解碼器表示場景,以 marching cubes 擷取網格;在部分觀測的粗網格中,未觀測的點由粗層解碼器預測佔據(Zhu et al., 2022a, Supp. A.4)。SplaTAM 以等向的三維高斯作為唯一地圖,全文與補充資料都沒有三維表面精度指標,幾何只以渲染深度的 L1 誤差評估(Keetha et al., 2024)。這些表示的性質,以及沒有被量測支持的表面如何產生,見 F-04 神經隱式表示、三維高斯與沒有被量測支持的表面。
論文中的管線與工地地圖
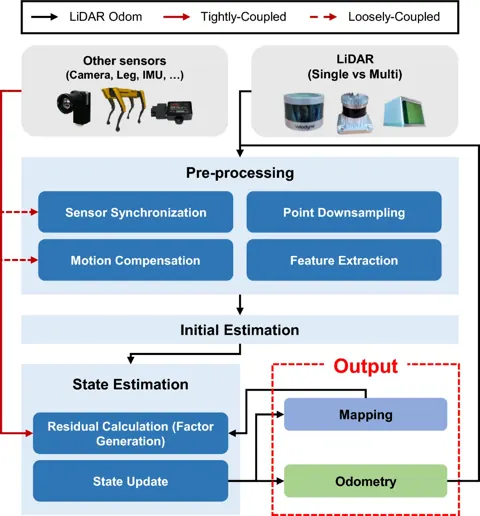
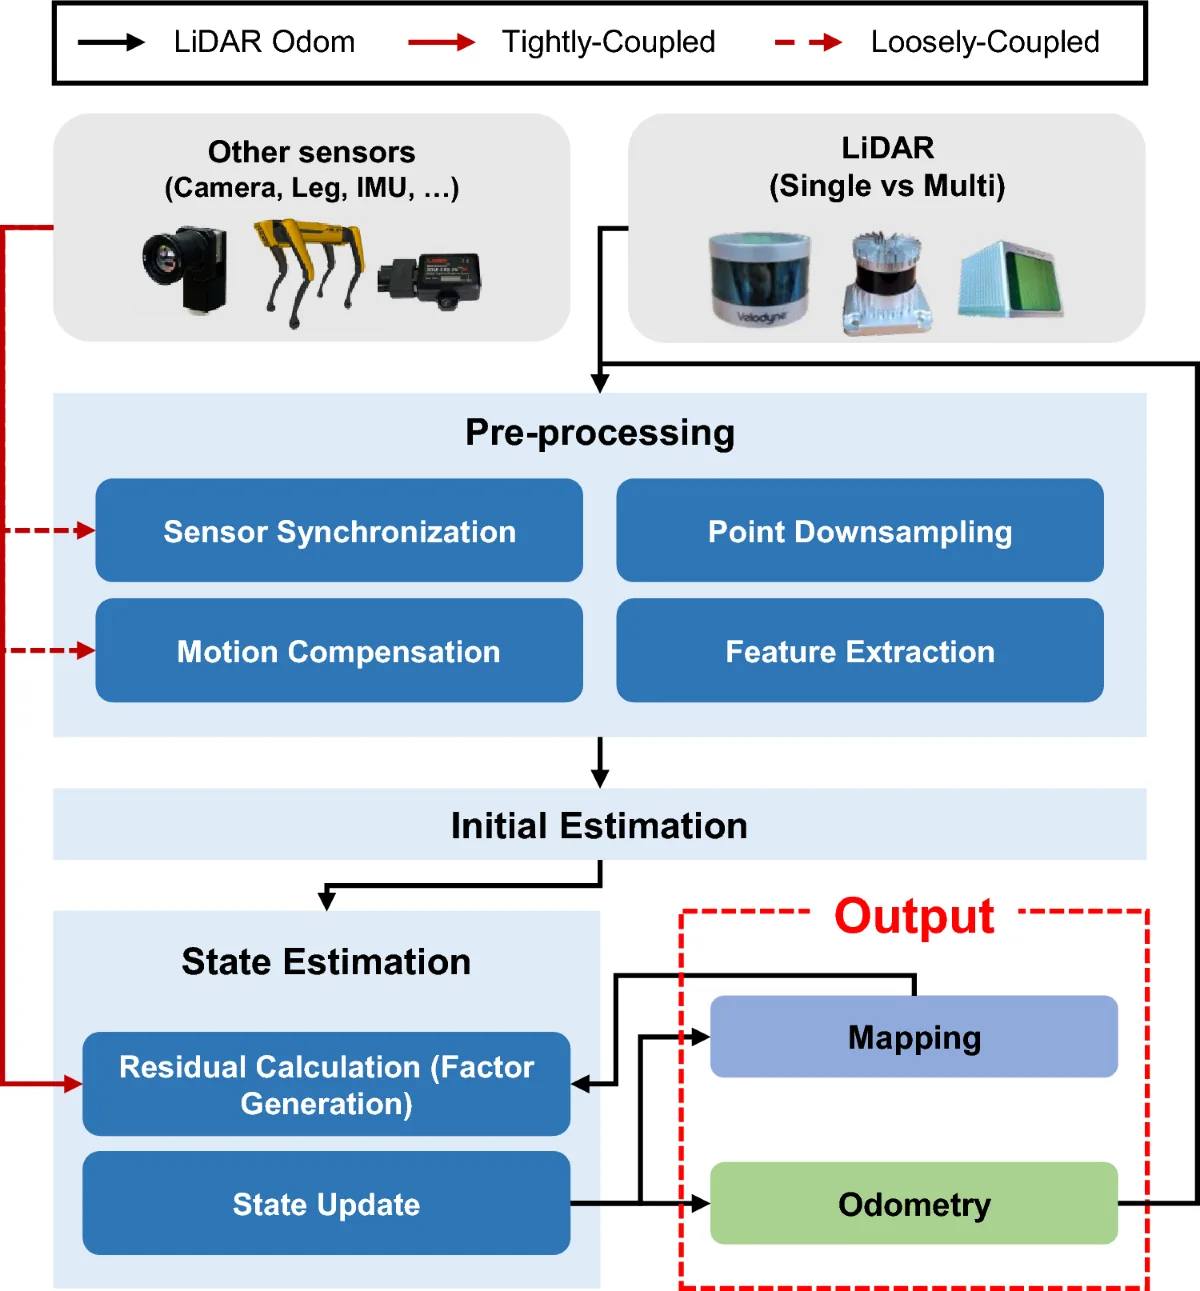
Fig. 3LiDAR 里程計通用流程:前處理(感測器同步、運動補償、降取樣、特徵擷取)、初始估計與狀態估計,並標示其他感測器以鬆耦合或緊耦合方式接入的位置
出處:Lee et al., 2024b,Fig. 3。授權:CC BY 4.0 (Springer open access, licence statement in the article)。原始圖檔。修改:轉存為 WebP 格式。
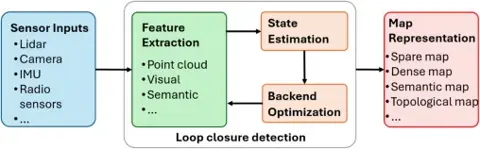
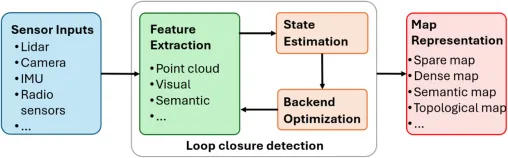
Fig. 6SLAM 生成流程:感測輸入、特徵擷取、狀態估計、後端最佳化與地圖建構
出處:Li et al., 2026a,Fig. 6。授權:CC BY 4.0。原始圖檔。修改:轉存為 WebP 格式。
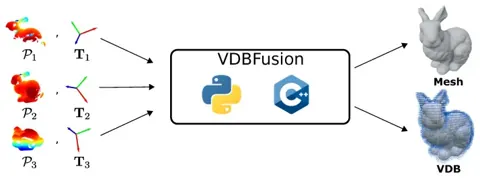
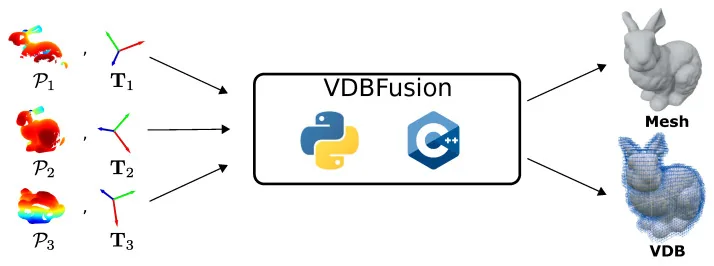
Figure 3系統總覽:輸入點雲與位姿,整合為稀疏 TSDF 後輸出網格或 VDB 資料
出處:Vizzo et al., 2022,Figure 3。授權:CC BY 4.0。原始圖檔。修改:轉存為 WebP 格式。
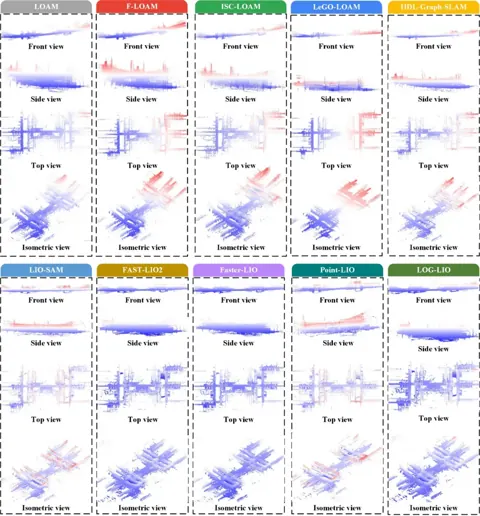
Fig. 16十種 SLAM 演算法在實際工地建出的點雲地圖,每種方法各有前視、側視、俯視與等角視圖
出處:Feng et al., 2025,Fig. 16。授權:CC BY 4.0。原始圖檔。修改:轉存為 WebP 格式。
本站證據:這幾類管線如何被報告
以下統計取自本站已查證的方法卡,於頁面產生時計算。LOAM 系列與特徵式 LiDAR 建圖共 34 張,其中 0 張的驗證環境含施工中工地;當代 LiDAR(慣性)里程計與 SLAM 共 36 張,其中 4 張;視覺、視覺慣性與 RGB-D 稠密 SLAM 共 49 張,其中 0 張;地圖表示與表面重建共 20 張,其中 1 張;學習式、神經隱式與高斯潑濺 SLAM 共 47 張,其中 1 張。視覺類群集中,地圖表示與輸出欄位只寫到稀疏地圖點、地標或關鍵影格,沒有提到任何稠密表示的卡片有 9 張。這些張數只計方法卡本身記錄的驗證環境;像 Feng 等那樣在工地比較既有方法的評估研究,以及工地資料集,都不是方法卡,不計入其中。個別方法可在方法目錄查詢;設備清單中可搜尋 與 FAST-LIO2 論文所用固態 LiDAR 同系列的設備紀錄與 與 KinectFusion 所用深度相機同名系列的設備紀錄,各筆附該研究報告的規格與出處。
本站各管線群集的方法卡
依本站已查證方法卡的群集分類。迴圈閉合依紀錄的迴圈閉合欄位:寫明無、未使用、未報告或不適用者不計,隱式或事後處理的迴圈修正也計入。施工中工地依驗證環境欄位。
按下圖例項目只顯示該系列,再按一次恢復全部系列。
按 Tab 進入圖表後,用上下方向鍵逐一瀏覽各類別,Esc 關閉提示框;也可開啟表格檢視閱讀全部數值。
一張方法卡只屬於一個群集;同一方法的不同版本可能各有一張卡。張數反映本站收錄的文獻分布,不代表各類方法在工地上的使用頻率。
資料來源本站已查證的方法卡(methods.json),於頁面產生時計算
| 方法 | 紀錄的輸出欄位(英文原文) | 驗證環境 |
|---|---|---|
| LOAM(2014) | motion-corrected registered point cloud map (5 cm voxel-grid downsampled) and 6-DoF pose at about 10 Hz (Sec. VI); dense raw-point export not described in paper | 公開基準、受控實驗、已完工建築、獨立參考量測 |
| LeGO-LOAM(2018) | feature-set point cloud map and 6-DoF poses (Sec. III-E); export of full-resolution map not described in paper | 公開基準、跨場域 |
| LIO-SAM(2020) | global feature map assembled from keyframe edge and planar feature clouds plus the keyframe trajectory; lidar frames between keyframes (1 m or 10 deg pose change) are discarded; maps are shown aligned with Google Earth imagery (Figs. 4 to 7); dense map export… | 跨場域、獨立參考量測 |
| FAST-LIO2(2022) | odometry and registered dense point map inserted at odometry rate; export format 原文未報告 in paper | 公開基準、受控實驗 |
| ORB-SLAM3(2021) | Keyframe trajectories and sparse map points (on EuRoC V202 the four ORB-SLAM3 configurations keep 9,686 to 14,245 map points and 135 to 332 keyframes, Table VI); no dense reconstruction is produced or evaluated in the paper | 公開基準 |
| ORB-SLAM2(2017) | keyframe trajectory and sparse map points; the dense point clouds shown are obtained by back-projecting sensor depth maps from estimated keyframe poses (Sec. IV-C, Fig. 7) | 公開基準 |
| KinectFusion(2011) | dense TSDF surface rendered by raycasting; mesh export not reported in sections read | 受控實驗 |
| Volumetric range-image integration (TSDF origin; VRIP)(1996) | watertight triangle mesh extracted as the zero isosurface; hole filling by tessellating between empty and unseen regions | 受控實驗 |
| RGB-D Mapping (Henry et al.)(2012) | globally optimised camera trajectory, dense coloured point cloud map and a surfel map (for example 28 million points combined into 1.4 million surfels, Sec. 4.4); export format 原文未報告 | 受控實驗、獨立參考量測 |
上一頁:設備的攜帶方式與作業流程見 D-06 攜帶平台與作業方式;點雲品質的評估方式見 Q-02。